強化学習とは?仕組みや教師あり・なし学習との違い、具体例まで

目次
- ▼1. 強化学習とは?機械学習の一分野
- ・強化学習の仕組み
- ・強化学習と教師あり学習・教師なし学習との違い
- ▼2. 強化学習で用いられる主なアルゴリズム一覧
- ▼3. 強化学習の活用分野・具体例
- ・ロボティクス
- ・AIエージェント
- ・自動運転
- ・金融サービス
- ▼4. 強化学習のメリット4つ
- ・正解ラベル付きデータを大量に用意する必要がない
- ・シミュレーション環境で大量の試行を実施できる
- ・未知の環境や長期的な目標に対応しやすい
- ・人が考えつかないような戦略を発見できる場合もある
- ▼5. 強化学習のデメリット・課題
- ・報酬設計が難しい
- ・シミュレーションと現実世界の動きに差異がある
- ・学習に膨大な計算リソースが必要になる
- ▼6. コンテナ型AIデータセンターの構築を支援する「ミライト・ワン コンテナDCワンストップソリューション」
- ▼7. まとめ
AI技術の進化に伴い、ロボットや自動運転、AIエージェントなど、自ら状況を判断して行動するAIの活用が広がっている。こうした技術を支えているのが、試行錯誤を繰り返しながら最適な行動を学習する「強化学習」である。
しかし、「強化学習とはどのような仕組みなのか」「教師あり学習や教師なし学習との違いがわからない」と疑問を持つ方も多いのではないだろうか。
そこで本記事では、強化学習の仕組みや教師あり学習・教師なし学習との違い、代表的なアルゴリズムと活用事例、メリット・デメリットについてわかりやすく解説する。
強化学習とは?機械学習の一分野
強化学習(RL:Reinforcement Learning)とは、AIが試行錯誤を重ね、行動の結果として得られる報酬をもとに、より良い行動を学習していく機械学習(ML:Machine Learning)の一分野である。
AIと機械学習、強化学習の関係性は、次のように表すことができる。
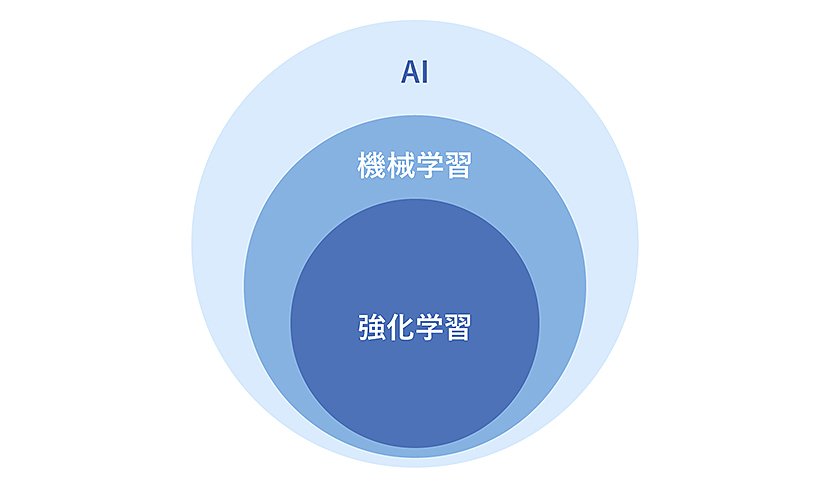
強化学習の考え方は、人間の行動心理学に影響を受けている。
例えば子供は、「片付けを行うと褒められ、逆におもちゃを散らかしっぱなしにすると叱られる」という経験を繰り返すうちに、どの行動が良い結果につながるかを学習していく。
強化学習も同様に、AIが試行錯誤を通じて、報酬につながる行動パターンを学習する仕組みである。ここでは、詳しい仕組みや他の手法との違いについて解説する。
●強化学習の仕組み
●強化学習と教師あり学習・教師なし学習との違い
強化学習の仕組み
強化学習の仕組みを理解するうえで、まず把握しておきたい次の5つの用語がある。
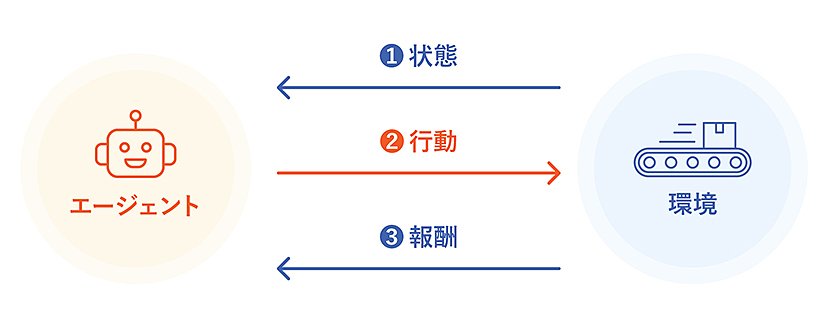
| <5つの用語> ●エージェント:行動し学ぶ主体(AI) ●環境:エージェントが行動する空間(工場ライン、ロボットの作業場所など) ●状態:エージェントの現在の状況(車のスピード、ロボットの位置など) ●行動:エージェントによる選択肢(進む、ものを掴むなど) ●報酬:行動に対して得られるスコア |
強化学習では、エージェントであるAIが現在の環境で状態を観測し、それをもとに行動を選択する。行動に応じた結果によって環境の状態が変わり、報酬が与えられる仕組みである。また、エージェントは、報酬であるスコアを最大化するために試行錯誤しながら、必要な行動を自律的に学習していく。
この流れを図解に表すと以下の通りである。
強化学習と教師あり学習・教師なし学習との違い
機械学習の学習法は、次のように「教師あり学習」と「教師なし学習」、「強化学習」の3つに大別される。
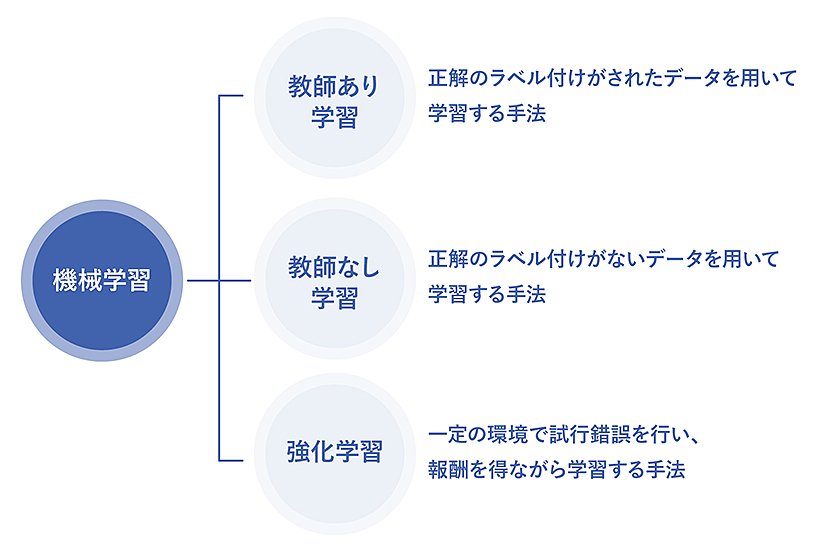
教師あり学習とは、正解のラベルが付けられたデータを用いて学習を進める手法である。例えば、乗り物の画像から種類(自動車、自転車、バイクなど)を認識するシステムを構築する場合、どの乗り物がどの種類に該当するかを示すデータセットを用意し、AIモデルに読み込ませてパターンを学習させる。
次に、教師なし学習とは、正解のラベルを用いずにデータのみで学習を進める手法である。具体的には、「自転車」であるという情報を与えずに自転車の画像データを入力し、学習させる。データが持つ特徴に基づいて分類することで、学習が進んでいく仕組みである。
強化学習が教師あり・教師なし学習と大きく異なるのは、エージェントが環境とやり取りしながら試行錯誤を重ね、その結果得られる報酬をもとに自律的に学習を進める点である。あらかじめ用意されたデータのみを学習する教師あり学習・教師なし学習とは異なり、自ら行動して経験を積みながら最適な行動を身につける点が、強化学習ならではの特徴といえる。
強化学習で用いられる主なアルゴリズム一覧
強化学習にはさまざまなアルゴリズムが用いられている。アルゴリズムとは、特定の課題解決に必要な手順やルールを指す。
強化学習で用いられるアルゴリズムは、報酬であるスコアを最大化するという目的は共通しているものの、学習の進め方はそれぞれ異なる。
強化学習で用いられる主なアルゴリズムを、以下の表にまとめた。
| アルゴリズムの種類 | 概要 | 活用事例 |
| Q学習(Q-Learning) | 状態と行動の組み合わせごとに報酬の期待値を推定して学習する | ・ゲームでの行動選択 ・ロボットの経路探索 など |
| Sarsa | 実際に選択した行動をもとに価値を学習する | ・ロボットの歩行制御 ・自動運転における安全性を重視した行動選択 など |
| モンテカルロ法 | エピソード終了後に報酬の合計から価値を評価する | ・ゲームAIの戦略立案 ・株式取引のシミュレーション など |
Q学習(Q-Learning)は、状態と行動の組み合わせごとに、将来得られる報酬の期待値(Q値)を推定する手法である。行動とその結果からQ値を更新しながら学習を進める。
Sarsaも、Q学習と同様に状態と行動の価値を学習する手法である。実際に選択した行動をもとに学習するため、安全性を重視する場面で選ばれやすい。
モンテカルロ法は、1つのエピソード(一連の行動)が終了するまで学習の更新を行わず、最終的に得られた報酬の合計をもとに各行動の価値をまとめて評価する手法のことである。
強化学習の活用分野・具体例
続いて、強化学習の活用分野・具体例を紹介する。
●ロボティクス
●AIエージェント
●自動運転
●金融サービス
ロボティクス
ロボティクスの分野では、強化学習の活用が進んでいる。例えば、人と同じ環境下で共通の道具を使って作業する二足歩行型のヒューマノイドロボットの開発では、次のような報酬を設定し、歩行動作の学習ができる。
●目標速度に沿って歩く:+10
●ぶつかって足が滑る:-5
シミュレーション環境でこうした学習を重ねた後に実機へ適用することで、ヒューマノイドロボットによる安定的な歩行が実現しやすくなる。
そのほか、ロボティクス分野では次のような活用例も見られる。
| <ロボティクス分野での活用例> ●ロボットアームの動作制御 ●物流倉庫における商品のピッキングと運搬 ●生産ラインにおける設備の稼働制御 |
ヒューマノイドロボットについて詳しくは、以下の記事を参考にされたい。
関連リンク:
ヒューマノイドロボットとは?今知るべき種類・活用分野・日本企業
ヒューマノイドロボットの市場規模は?2030年・2050年予測と各国の動向
ヒューマノイドロボットの課題7つと解決策|技術・コスト・安全面まで
AIエージェント
AIエージェントとは、あらかじめ設定された目標や課題に対し、自律的にタスクを実行するソフトウェアを指す。AIエージェントにはいくつかの種類があり、「学習エージェント」というタイプで強化学習が主に活用されている。
AIエージェントが状況を把握して意思決定を最適化し、行動を選択することで、複雑なタスクの処理が可能になる点が特徴である。
業務の効率化や生産性向上が期待できることから、企業での導入が進んでいる。AIエージェントの活用例は、以下の通りである。
| <AIエージェントでの活用例> ●過去の購買履歴から、顧客ごとの好みに合った商品のレコメンド ●医療機関で受診データを学習し、次回の予約タイミングを自動で設定 ●需要予測に基づく在庫量・発注タイミングの自動調整 |
AIエージェントについて詳しくは、以下の記事を参考にされたい。
関連リンク:【図解あり】AIエージェントとは?仕組みや種類、生成AIとの違いを解説
自動運転
強化学習は、自動運転の分野でも活用されている。
強化学習では、正確で安全な運転の仕方だけでなく、車線から外れそうになった状態から正常な状態に戻す方法まで学習する。環境(道路状況)から学習するため、人間のような判断を自律的に身につけられるようになる。
具体的には、次のような活用例がある。
| <自動運転分野での活用例> ●ブレーキを踏むタイミング ●減速の判断 ●障害物の回避 |
金融サービス
金融サービス業界においては、リスクを適切に管理しながら長期的なリターンの最大化を図るために、強化学習が活用されている。
金融市場は価格や外部環境の変動が激しく、状況に応じた判断を下すことが求められる。こうした特性は、試行錯誤を通じて最適な行動を学習していく強化学習のアプローチと親和性が高い。
具体的な活用例は、以下の通りである。
| <金融サービスでの活用例> ●市場シナリオのシミュレーションと株式取引の自動対応 ●ポートフォリオの最適化 ●価格変動リスクの低減 |
強化学習のメリット4つ
ここでは、強化学習を活用する4つのメリットを紹介する。
●正解ラベル付きデータを大量に用意する必要がない
●シミュレーション環境で大量の試行を実施できる
●未知の環境や長期的な目標に対応しやすい
●人が考えつかないような戦略を発見できる場合もある
正解ラベル付きデータを大量に用意する必要がない
強化学習の大きなメリットは、正解ラベル付きの学習データをあらかじめ用意しなくても学習が進められる点にある。
教師あり学習では、正解を示す大量のデータセットを事前に準備する必要があるが、強化学習ではエージェントが環境との相互作用を通じて自ら経験を重ねることで学習していく。
例えば、MRI画像から病気を診断するAIを教師あり学習で構築する場合、正確なラベルを付けたデータを大量に用意しなければならない。難易度や専門性が高く、コストもかかってしまう。
一方、強化学習であればこうしたデータを大量に準備する必要はない点がメリットといえる。
シミュレーション環境で大量の試行を実施できる
強化学習では、実環境ではなくシミュレーション環境の中でエージェントに試行錯誤をさせることで、学習に必要な試行回数を大幅に増やすことができる。
ロボットの動作制御や自動運転のような領域では、実機を使って実験を繰り返すと、故障や事故のリスクが伴ううえ、1回の試行にも時間がかかる。一方、シミュレーション環境上であれば、エージェントが失敗しても実害は発生しない。
現実世界では実施が難しいほどの回数の試行を、短期間で積み重ねられる点がメリットの一つである。
未知の環境や長期的な目標に対応しやすい
強化学習は、未知の環境や長期的な目標にも対応しやすいというメリットを持つ。
エージェントは環境から得られる報酬をもとに行動を修正していくため、あらゆる状況を事前に細かくルール化しておかなくても、未知の状況に応じて柔軟に立ち回ることができる。
また強化学習は、目の前の報酬だけでなく、将来にわたって得られる報酬の合計を最大化するように学習が進む。こうした特徴が、前述の金融サービス領域などにも活かされている。
人が考えつかないような戦略を発見できる場合もある
強化学習には、人間が考えつかなかったような戦略やパターンを発見できる可能性がある。
強化学習では、あらかじめ正解となる行動パターンを教えるわけではないため、エージェントは試行錯誤の過程で、人間が思いつかない行動を独自に見つけ出す場合がある。人間の先入観にとらわれない答えを導き出せる点は、強化学習ならではの強みだといえる。
強化学習のデメリット・課題
強化学習には多くのメリットがある一方で、運用にあたって留意すべき課題も存在する。ここでは、3つのデメリット・課題を解説する。
●報酬設計が難しい
●シミュレーションと現実世界の動きに差異がある
●学習に膨大な計算リソースが必要になる
報酬設計が難しい
強化学習において、どのような行動にどれだけの報酬を与えるかという設計は、重要でありながら難しい要素の一つである。不適切に設定してしまうと、意図とは異なる行動を学習してしまう現象が起こる可能性がある。
例えば、自動運転で目的地への到着速度だけを評価すると、危険運転を学習してしまう恐れがある。この場合、スピードだけでなく、安全面などさまざまな要素を考慮したうえで報酬を設計することが大切となる。
シミュレーションと現実世界の動きに差異がある
一般的に、強化学習はコンピューター上のシミュレーション環境で学習が進められる。しかし、シミュレーションと現実世界には、物理的な差異が存在し、仮想空間で学習した動きがそのまま現実で再現できるとは限らない。
例えば、ヒューマノイドロボットの歩行動作は、シミュレーション上では滑らかに歩けていたとしても、実機に適用するとバランスを崩すこともある。
こうした差異は「Sim2Real Gap」と呼ばれており、環境のばらつきをシミュレーション環境で再現するような工夫が求められている。
このギャップが残ったままでは、シミュレーションで得た成果を現場で再現できず開発コストが無駄になりかねない。その解消は、強化学習を実運用へ展開するうえで欠かせない要素となる。
なお、このようにシミュレーションと現実のギャップを埋め、仮想環境での学習成果を実機に適用しようとする技術は「Sim2Real(Simulation to Real)」と総称される。摩擦や重量などのパラメータを、あえてばらつかせて学習させる手法などが用いられている。
学習に膨大な計算リソースが必要になる
強化学習で扱う課題や目的によっては、膨大な回数のシミュレーションによる学習プロセスが発生し、多くの計算リソースや長い時間が必要になる場合がある。
特に、強化学習をさらに発展させた手法である深層強化学習では、計算負荷が高くなりやすい。こうした負荷の高い学習を安定して実行するには、GPUをはじめとする高性能な計算環境と、それを支える拡張性の高いインフラの整備が欠かせないだろう。
コンテナ型AIデータセンターの構築を支援する「ミライト・ワン コンテナDCワンストップソリューション」
強化学習を用いたAI開発が広がるにつれ、企業にはGPUをはじめとする大規模な計算力を柔軟に確保できる環境が求められている。しかし、既存のビル型データセンターでは、新設に時間がかかるうえ拡張性にも乏しく、需要の高まりに即座に対応することは難しい。
こうした課題を受け、株式会社ミライト・ワンはモルゲンロット株式会社と共同で、コンテナ型AIデータセンターの構築からクラウドサービス化までを一気通貫で実現する「ミライト・ワン コンテナDCワンストップソリューション」の提供を開始した。
設計・施工から運用・保守までをワンストップで担うことで、最短6ヶ月というスピードでの建設を実現している。また、必要な計算力を必要な分だけ利用できるGPUクラウドマッチングサービスも備えている。
詳しくは、以下のリンクを確認されたい。
コンテナ型AIデータセンターの構築からクラウドサービス化まで一気通貫で提供する「ミライト・ワン コンテナDCワンストップソリューション」を提供開始 ~モルゲンロット社と研究・開発・検証用の専用ラボ開設
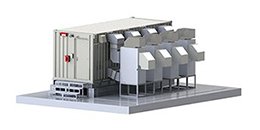
コンテナ型データセンター
まとめ
強化学習とは、AIが試行錯誤を重ね、行動の結果として得られる報酬をもとに行動を学習していく機械学習の一分野である。教師あり学習・教師なし学習とは異なり、エージェントが環境とのやり取りを通じて自律的に学習を進める点に特徴がある。
ロボティクスやAIエージェント、自動運転など幅広い分野で活用が進む一方、報酬設計の難しさや学習に必要な計算リソースの負荷といった課題も存在する。強化学習を活用したAI開発を進めるにあたっては、こうした課題を踏まえたうえで、GPUなどの計算リソースを柔軟に確保できる環境を整えることが重要である。
株式会社ミライト・ワンは、こうした計算リソースの確保を支援する「ミライト・ワン コンテナDCワンストップソリューション」を提供している。設計・施工から運用・保守までを一気通貫で担い、最短6ヶ月というスピードでコンテナ型AIデータセンターの構築をサポートする。
強化学習をはじめとするAI開発基盤の整備を検討する場合には、以下のリンクを確認されたい。
コンテナ型AIデータセンターの構築からクラウドサービス化まで一気通貫で提供する「ミライト・ワン コンテナDCワンストップソリューション」を提供開始 ~モルゲンロット社と研究・開発・検証用の専用ラボ開設
コンテナ型データセンター
あわせて読みたい記事


関連するソリューション
ミライト・ワンのソリューションに関するご質問、ご相談など
ございましたらお気軽にお問い合わせください。
最新の特集
ドローン特集